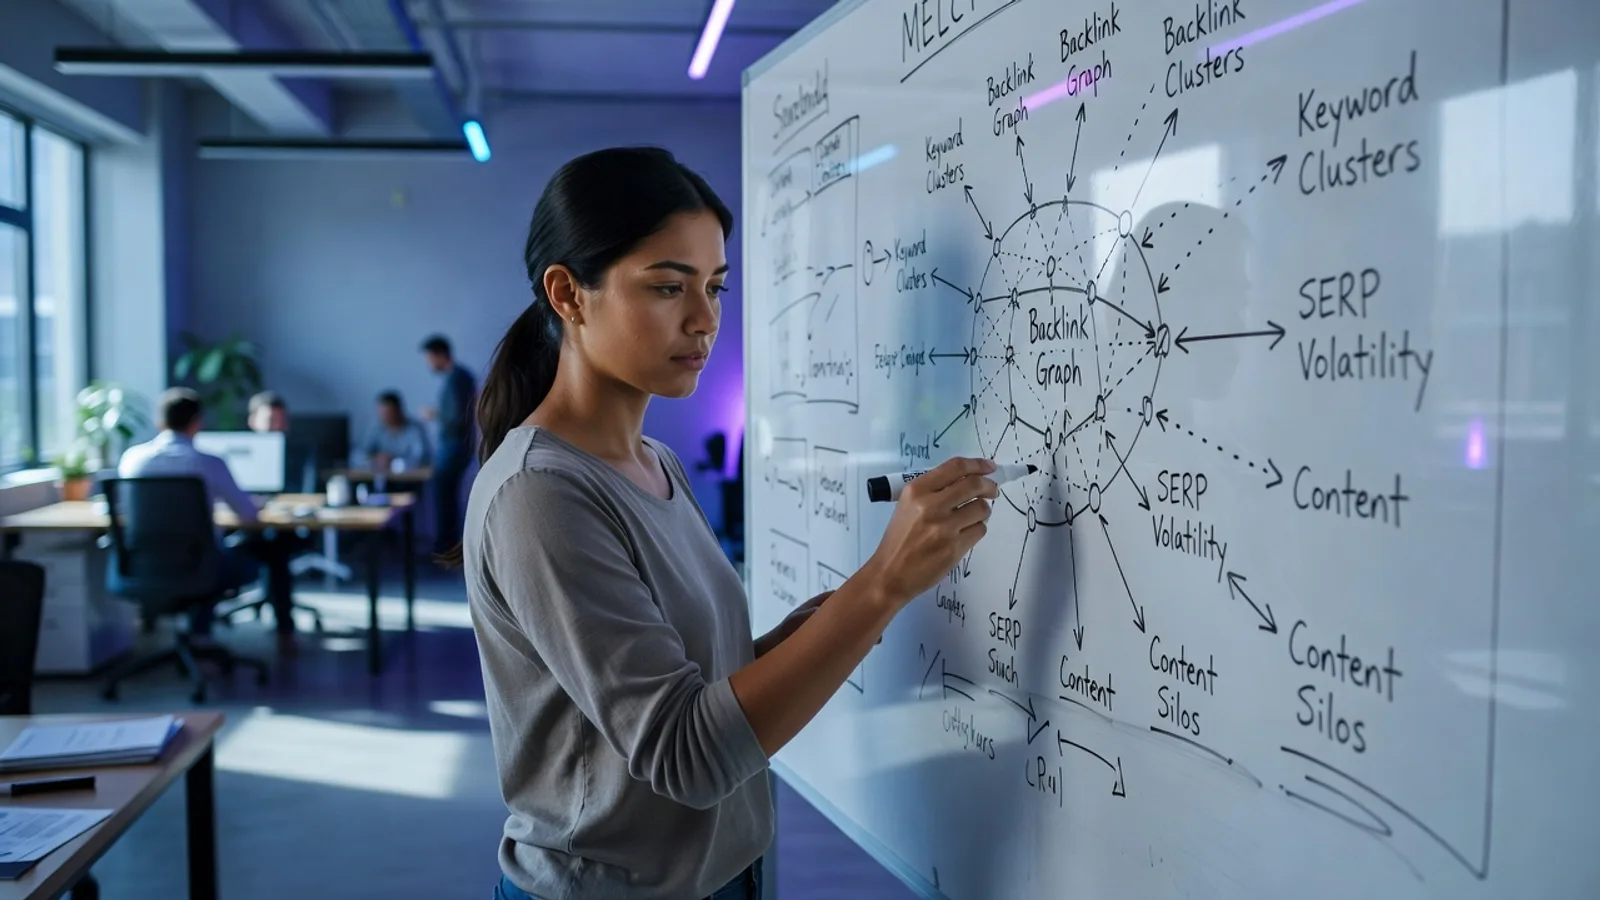
Инвертированный граф знаний представляет собой высокоорганизованную структуру данных, где вместо традиционного связывания сущностей друг с другом мы фокусируемся на связывании запросов, намерений пользователей и фрагментов контента с центральными сущностями. Это позволяет поисковым системам, особенно основанным на искусственном интеллекте, мгновенно устанавливать релевантные связи между поисковым запросом, его скрытым смыслом и наиболее точным, авторитетным ответом. Такой подход критически важен для AEO-доминирования, поскольку он не только улучшает видимость, но и гарантирует, что ваш контент будет предпочтительным источником для формирования прямых ответов ИИ-ассистентов, создавая сквозные сущности и прочную информационную основу для ранжирования.
От классического графа к инвертированному: смена парадигмы
Классический граф знаний, активно используемый Google и другими поисковыми системами, фокусируется на связях между сущностями: кто что изобрел, где что находится, какие события связаны. Это помогает ИИ понимать мир. Однако для задач Answer Engine Optimization (AEO) и эффективного ранжирования в ИИ-ответах нам нужен иной фокус. Инвертированный граф знаний меняет перспективу: его центр — это не столько сама сущность, сколько запрос или намерение пользователя, связанное с этой сущностью. Мы строим связи от потенциальных вопросов и потребностей к наиболее точным и полным ответам, где наш контент выступает как авторитетный источник. Иными словами, мы создаём не просто карту мира, а карту ответов на вопросы, относящиеся к нашему бизнесу или экспертной области.
Такая инверсия позволяет поисковым алгоритмам мгновенно определять, какой фрагмент информации из какого документа наилучшим образом отвечает на конкретный запрос. Это особенно ценно в условиях, когда ИИ-ассистенты генерируют ответы, опираясь на десятки источников, и выборка наиболее релевантного фрагмента становится критически важной. Инвертированный граф не просто индексирует контент; он предсказывает, какие части контента будут востребованы для прямого ответа, и устанавливает эти связи заранее.
Почему инвертированный граф необходим для ИИ-поиска
- Обеспечивает точность ответов: ИИ-системы стремятся дать один, максимально точный ответ. Ваш контент, связанный через инвертированный граф, получает приоритет.
- Улучшает формирование сквозных сущностей: Позволяет ИИ понимать, как различные части вашего контента формируют целостное представление о продукте, услуге или концепции, создавая единую «сквозную сущность».
- Сокращает путь к ответу: ИИ не тратит время на анализ всего документа, а сразу обращается к помеченным фрагментам, что ускоряет выдачу и повышает шансы на выбор вашего контента.
- Усиливает авторитетность: Если ваш контент постоянно выбирается как источник ответов, это сигнализирует поисковым системам о его высокой авторитетности и релевантности.
- Оптимизация для голосового поиска: Для голосовых ассистентов, которым нужен один, быстрый и чёткий ответ, инвертированный граф становится незаменимым инструментом.
Этапы создания инвертированного графа знаний
Создание инвертированного графа знаний — это стратегический процесс, который требует глубокого понимания как контента, так и ожиданий пользователя. Это не одноразовая задача, а непрерывный цикл оптимизации.
1. Глубокий анализ намерений пользователя и запросов
Первый и самый важный шаг — выход за рамки простых ключевых слов. Мы должны понять не только, что спрашивают пользователи, но и почему они это спрашивают. Используйте расширенные инструменты анализа поисковых запросов, изучите связанные вопросы в выдаче, анализируйте логи чатов с поддержкой, опросы клиентов. Цель — выявить все возможные синонимы, формулировки и вариации запросов, которые могут привести к вашей сущности. Также важно определить тип намерения: информационное (что это?), навигационное (как найти?), транзакционное (как купить?), сравнительное (что лучше?). Каждое намерение требует специфического типа ответа и соответствующей структуры контента.
2. Выделение ключевых сущностей и их атрибутов
Определите основные сущности, о которых ваш контент даёт информацию. Это могут быть продукты, услуги, концепции, люди, места. Для каждой сущности необходимо выделить её ключевые атрибуты: характеристики, преимущества, недостатки, связи с другими сущностями, способы применения, стоимость, доступность. Например, для сущности «CRM-система» атрибутами могут быть «интеграция с 1С», «мобильное приложение», «облачное решение», «цена подписки», «отзывы пользователей». Каждый атрибут является потенциальным ответом на конкретный вопрос.
3. Сопоставление запросов с сущностями и контентными фрагментами
На этом этапе мы начинаем строить инвертированные связи. Для каждого потенциального запроса или намерения пользователя определите, какая сущность является ключевой и какой конкретный фрагмент вашего контента даёт наиболее точный и полный ответ. Это может быть заголовок, абзац, элемент списка, таблица или даже инфографика. Размечайте эти фрагменты. Для сложных запросов, требующих агрегации данных, можно указывать несколько фрагментов из разных источников на вашем сайте.
«В эпоху ИИ-поиска ваш контент должен быть не просто информативным. Он должен быть 'ответоспособным'. Инвертированный граф знаний — это наш инструмент для формирования такой 'ответоспособности' на системном уровне.»
— Алиса Ремезова, GEO/AEO-стратег Rusability
4. Структурирование и разметка контента
Оптимизируйте контент для машинного чтения. Используйте семантическую разметку (Schema.org) для явного обозначения сущностей и их атрибутов. Внутри текста применяйте чёткие заголовки (H2, H3, H4) для выделения ответов на конкретные вопросы. Формулируйте определения в виде коротких, самодостаточных предложений. Используйте нумерованные и маркированные списки, таблицы для структурированной передачи данных. Каждый значимый фрагмент контента должен быть потенциально извлекаемым и цитируемым.
5. Формирование сквозных сущностей
Сквозная сущность — это полное и согласованное представление об объекте (продукте, услуге, персоне), собранное из всех релевантных источников на вашем ресурсе. Инвертированный граф помогает ИИ собрать все фрагменты в единое целое. Например, если у вас есть страница продукта, статьи в блоге о его применении, отзывы клиентов и FAQ, инвертированный граф связывает их таким образом, чтобы ИИ видел их как части одной сквозной сущности. Это повышает авторитет и полноту информации, которая будет предоставлена пользователю.
6. Мониторинг и итерационная оптимизация
ИИ-поиск постоянно развивается. Отслеживайте, какие фрагменты вашего контента используются для ответов ИИ, анализируйте изменения в поисковой выдаче и поведении пользователей. Добавляйте новые запросы, уточняйте связи, актуализируйте контент. Этот процесс итерационный, требующий постоянной доработки и расширения графа.
Пример создания инвертированного графа для компании-разработчика ПО
Представим компанию «ТехноСофт», которая разрабатывает и продаёт CRM-систему «OptiCRM». Их цель — доминировать в ответах ИИ-ассистентов по запросам, связанным с CRM.
Шаг 1: Анализ запросов
«ТехноСофт» анализирует тысячи запросов: «что такое CRM», «лучшая CRM для малого бизнеса», «как выбрать CRM», «интеграция CRM с телефонией», «сколько стоит OptiCRM», «отзывы OptiCRM». Они выявляют, что пользователи ищут как общие определения, так и специфические характеристики, сравнения и стоимость.
Шаг 2: Выделение сущностей и атрибутов
Ключевая сущность — «OptiCRM». Атрибуты: «функционал», «интеграции», «тарифы», «безопасность», «поддержка», «отзывы», «преимущества перед конкурентами». Сущности второго уровня: «Модуль отчетов OptiCRM», «Интеграция с 1С в OptiCRM» и т.д.
Шаг 3: Сопоставление и создание сквозной сущности
На странице продукта «OptiCRM» они создают раздел «Что такое OptiCRM?», который напрямую отвечает на запрос «что такое OptiCRM». На странице «Тарифы» подробно описывают стоимость, отвечая на «сколько стоит OptiCRM». В блоге есть статья «10 причин выбрать OptiCRM», которая служит ответом на запрос «почему OptiCRM лучше». Страница с отзывами клиентов даёт ответы на «отзывы OptiCRM». Все эти фрагменты контента внутренне ссылаются друг на друга, формируя целостную сквозную сущность «OptiCRM».
«Инвертированный граф знаний для AEO — это не просто новый инструмент, а фундаментальный сдвиг в нашем понимании того, как контент должен взаимодействовать с поисковыми системами. Мы переходим от 'чтобы меня нашли' к 'чтобы меня цитировали'.»
— Полина Морозова, ведущий специалист по контент-стратегии
Шаг 4: Разметка и оптимизация
«ТехноСофт» использует Schema.org для разметки типов контента (Product, Article, Review) и их свойств. Заголовки H2/H3 на всех страницах формулируются как прямые ответы на вопросы. Например, H2 «Что такое облачная CRM?» или H3 «Стоимость подписки на OptiCRM». Определение CRM даётся в первом абзаце соответствующей статьи коротким, чётким предложением. Списки преимуществ и функций также выделены.
В результате, когда пользователь спрашивает ИИ-ассистента «Что такое CRM-система и сколько стоит OptiCRM?», ИИ быстро находит соответствующее определение на сайте «ТехноСофт» и тарифную сетку, предоставляя исчерпывающий ответ, который будет выглядеть авторитетным и полным. Это приводит к значительному росту цитируемости контента «ТехноСофт» в ответах ИИ и, как следствие, к увеличению органического трафика и доверия к бренду.
Практические выводы для AEO-доминирования
- Фокусируйтесь на намерениях, а не на ключевых словах: понять, что пользователь хочет узнать или сделать, важнее, чем просто знать слова в его запросе.
- Создавайте «ответоспособный» контент: каждое определение, список, таблица должны быть максимально чёткими и самодостаточными, чтобы ИИ мог их извлечь и цитировать.
- Используйте семантическую разметку (Schema.org) последовательно и полно: это ваш основной язык общения с ИИ для описания сущностей и связей.
- Стройте сквозные сущности: убедитесь, что весь ваш контент, относящийся к одному объекту, связан между собой и даёт полное, согласованное представление.
- Регулярно анализируйте SERP и ответы ИИ: это поможет выявить новые возможности для оптимизации и улучшить граф знаний.
- Мыслите как ИИ-ассистент: если бы вы были алгоритмом, какой контент вы бы выбрали для ответа на этот запрос? Структурируйте свой контент именно так.
Технические инструменты для построения инвертированных графов
Создание инвертированного графа знаний — это не только методологическая, но и техническая задача. Для эффективного построения и управления таким графом необходим арсенал инструментов. Выбор конкретного решения зависит от масштаба проекта, доступных ресурсов и специфики данных. Главное, чтобы выбранные инструменты позволяли автоматизировать рутинные процессы, облегчали интеграцию данных и поддерживали масштабирование.
Платформы для управления знаниями и графовые базы данных
Основой для инвертированного графа часто становятся специализированные системы. Графовые базы данных, такие как Neo4j, ArangoDB или Amazon Neptune, идеально подходят для хранения и запросов сложных взаимосвязей между сущностями. Они позволяют нативно работать с рёбрами и вершинами, что существенно упрощает реализацию инвертированной логики. В отличие от реляционных баз, графовые системы не требуют сложных JOIN-операций для извлечения связей, что ускоряет обработку данных.
Помимо графовых баз, существуют комплексные платформы для управления знаниями (Knowledge Management Systems, KMS), которые могут включать функционал для работы с онтологиями и семантическими сетями. Они предоставляют более высокий уровень абстракции, предлагая готовые интерфейсы для создания и редактирования сущностей, атрибутов и связей. Некоторые из них поддерживают стандарты вроде OWL (Web Ontology Language) и RDF (Resource Description Framework), что важно для совместимости и обмена данными.
Инструменты для извлечения сущностей и анализа текста
Качество инвертированного графа напрямую зависит от точности извлечения сущностей из контента. Здесь на помощь приходят методы обработки естественного языка (NLP) и машинного обучения. Существуют готовые библиотеки и сервисы, способные автоматизировать этот процесс.
- Извлечение именованных сущностей (Named Entity Recognition, NER): инструменты вроде SpaCy, NLTK (для Python) или облачные API от Google, Amazon (Comprehend) и Microsoft (Azure Text Analytics) могут автоматически находить и классифицировать сущности (люди, организации, локации, продукты).
- Сопоставление сущностей (Entity Linking/Disambiguation): для связывания извлечённых сущностей с существующими элементами в графе и разрешения неоднозначности (например, "Яблоко" как фрукт или компания). Используются внутренние словари и внешние базы знаний, такие как Wikidata.
- Извлечение отношений (Relation Extraction): помогает определить, как сущности связаны друг с другом (например, "разработчик Х работает над продуктом Y"). Это более сложная задача, требующая часто обучения кастомных моделей.
Эти инструменты позволяют значительно сократить ручной труд при первичном наполнении графа и его последующем обновлении. Однако они требуют тонкой настройки и пост-модерации, чтобы избежать ошибок и неточностей.
Системы для мониторинга и аналитики
Чтобы инвертированный граф оставался актуальным и эффективным, необходим постоянный мониторинг его производительности и взаимодействия с ИИ-системами. Аналитические инструменты должны отслеживать, какие фрагменты контента чаще всего цитируются, как меняется видимость по целевым запросам и какие сущности требуют доработки.
- Инструменты веб-аналитики: Google Analytics 4, Яндекс Метрика, Heap Analytics позволяют отслеживать поведение пользователей после перехода из поисковых систем, включая те, что используют ИИ-ответы. Важно анализировать показатели вовлечённости и конверсии по страницам, которые формируют ответы.
- Платформы для AEO-мониторинга: специализированные сервисы, которые помогают отслеживать, как ваш контент отображается в ответах поисковых ассистентов (например, в блоках с ответами, 'featured snippets' или генеративных суммарных ответах). Они могут показывать, какие сущности и утверждения были использованы.
- Мониторинг запросов: отслеживание динамики запросов, связанных с вашими сущностями, позволяет выявлять новые намерения пользователей и адаптировать граф знаний. Это можно делать через Google Search Console, SimilarWeb, Ahrefs и другие SEO-платформы.
В целом, связка графовой базы данных, NLP-инструментов для автоматической обработки текста и аналитических систем создаёт мощную инфраструктуру для реализации и поддержки инвертированного графа знаний. Без этих технических решений масштабировать подход будет крайне сложно.
Интеграция инвертированного графа с RAG-системами и корпоративными ИИ
В современном ландшафте ИИ инвертированный граф знаний становится не просто инструментом для поисковой оптимизации, но и ключевым компонентом для повышения эффективности генеративных моделей. Его ценность многократно возрастает при интеграции с Retrieval-Augmented Generation (RAG) системами и внутренними корпоративными ИИ-решениями.
Инвертированный граф как база знаний для RAG
RAG-системы (системы генерации с дополненной выборкой) — это подход, при котором большая языковая модель (LLM) перед генерацией ответа обращается к внешней базе знаний для извлечения релевантной информации. Инвертированный граф идеально подходит на роль такой базы, поскольку он уже структурирован по намерениям и запросам пользователей, а не по документам.
Когда пользователь задаёт вопрос RAG-системе, механизм выбора (retriever) использует этот запрос для поиска наиболее релевантных сущностей и их атрибутов в инвертированном графе. Вместо того чтобы просматривать тысячи документов, система мгновенно находит точные фрагменты контента, связанные с конкретным намерением. Это даёт ряд преимуществ:
- Повышение точности ответов: LLM получает точечную, предварительно отобранную информацию, что снижает вероятность "галлюцинаций" и ошибок.
- Актуальность данных: инвертированный граф легче поддерживать в актуальном состоянии, обновляя отдельные сущности, а не переобучая всю модель.
- Эффективность: уменьшается объём контекста, который нужно подавать в LLM, что снижает вычислительные затраты и ускоряет процесс генерации.
- Управляемость: можно точно контролировать, какие источники информации используются для генерации ответа, приоритизировать проверенные данные.
- Расширенный контекст: граф позволяет LLM не просто получить факт, но и понять связи между фактами, что ведёт к более глубоким и многогранным ответам.
Инвертированный граф служит для RAG-систем не просто хранилищем фактов, а интеллектуальным фильтром, который подаёт генеративной модели именно тот контент, который максимально соответствует текущему пользовательскому запросу и его глубинному смыслу. Это радикально меняет качество взаимодействия с ИИ.
— Алиса Ремезова, GEO/AEO-стратег
Внутренние применения: корпоративные ИИ-ассистенты и базы знаний
За пределами публичного поиска, инвертированный граф знаний находит применение в корпоративных системах. Компании всё активнее внедряют внутренних ИИ-ассистентов для сотрудников, автоматизируют поддержку клиентов и создают интеллектуальные базы знаний. Здесь инвертированный граф становится центральным элементом.
Пример: крупная SaaS-компания может использовать инвертированный граф для обучения своего внутреннего ИИ-помощника. Вместо того чтобы сотрудник искал нужную информацию в десятках внутренних документов (Вики, документация по продукту, CRM, база знаний службы поддержки), ИИ-ассистент, подкреплённый инвертированным графом, мгновенно предоставит точный ответ. Если сотрудник спрашивает: "Как обновить подписку клиента N с тарифа Basic до Pro, если у него есть активные интеграции?", ИИ не просто найдёт инструкцию, а предоставит пошаговый алгоритм, учитывающий специфику клиента и его интеграций, поскольку все эти сущности (клиент, подписка, тариф, интеграция, обновление) и их взаимосвязи описаны в графе.
Это приводит к ускорению бизнес-процессов, снижению ошибок и повышению продуктивности. Инвертированный граф становится своего рода "цифровым мозгом" организации, который агрегирует и систематизирует знания таким образом, чтобы они были максимально доступны и полезны для автоматизированных систем и сотрудников.
Проблемы и вызовы при внедрении инвертированных графов
Хотя инвертированные графы знаний открывают огромные перспективы, их внедрение сопряжено с рядом сложностей. Важно осознавать эти вызовы заранее, чтобы планировать ресурсы и стратегии их преодоления.
Объём и сложность данных
Создание инвертированного графа требует глубокой проработки и структурирования огромных объёмов информации. Чем больше контента и сущностей, тем сложнее становится процесс выделения, классификации и связывания. Ошибки на этапе разметки или извлечения сущностей могут привести к неверным ответам ИИ.
Проблема масштабирования: по мере роста объёма контента и числа сущностей ручной подход становится невозможным. Необходимо внедрять автоматизированные методы с использованием NLP, но и они не идеальны и требуют постоянного контроля качества.
Поддержание актуальности и консистентности
Мир меняется, и информация устаревает. Инвертированный граф должен постоянно обновляться, чтобы отражать текущее состояние дел. Это касается не только фактов, но и пользовательских интентов, которые эволюционируют. Поддержание консистентности данных между различными источниками и предотвращение дублирования — тоже непростая задача.
Решение: регулярные аудиты графа, автоматизированные проверки на устаревшие данные, интеграция с источниками "живых" данных (например, API продуктов или услуг), а также чётко определённые процессы внесения изменений.
Техническая сложность и ресурсные затраты
Разработка и внедрение инвертированного графа требует компетенций в различных областях: от семантического моделирования и лингвистики до работы с графовыми базами данных и машинным обучением. Это влечёт за собой значительные ресурсные затраты на квалифицированных специалистов и соответствующую инфраструктуру.
Высокий порог входа: не каждая компания располагает необходимыми кадрами или бюджетом для полноценной реализации такого проекта с нуля. Часто приходится привлекать внешних экспертов или инвестировать в обучение внутренней команды. Важно также обеспечить интеграцию нового решения с существующей IT-инфраструктурой.
Оценка эффективности и ROI
Измерить прямую отдачу от инвестиций в инвертированный граф может быть непросто. Его эффект проявляется не только в прямом росте трафика, но и в улучшении качества ИИ-ответов, повышении удовлетворённости пользователей, снижении нагрузки на поддержку и других косвенных метриках.
Важно заранее определить ключевые показатели успеха (KPIs), которые будут отражать как прямое влияние на AEO-метрики (позиции в ответах ИИ, охват запросов), так и косвенное влияние на бизнес (конверсия, время на решение проблемы, NPS). Без чёткой системы метрик сложно будет доказать ценность такого масштабного проекта.


Комментарии (0)
Без регистрации. Комментарии проверяются автоматически перед публикацией.
Пока нет комментариев. Будьте первым!