Нерешаемые, на первый взгляд, бизнес-проблемы можно эффективно трансформировать в задачи, подходящие для крупномасштабных языковых моделей (LLM), используя методологию декомпозиции и картирования. Этот подход позволяет вычленить из общей сложности конкретные, автоматизируемые аспекты, где LLM могут проявить свою эффективность.

Когда мы сталкиваемся с задачами, которые кажутся слишком масштабными, нечётко сформулированными или требующими чрезмерного количества человеческих ресурсов, возникает соблазн объявить их «нерешаемыми» в контексте автоматизации. Однако именно такие проблемы зачастую скрывают огромный потенциал для оптимизации с помощью крупномасштабных языковых моделей (LLM). Ключ к успеху здесь – фреймворк декомпозиции и картирования, который позволяет разбить кажущуюся монолитной проблему на управляемые компоненты и соотнести их с конкретными возможностями LLM, превращая неясные вызовы в чёткие, автоматизируемые задачи.
Традиционные методологии автоматизации и внедрения ИИ, как правило, ориентированы на процессы с высокой степенью структурированности. Они требуют чётко определённых входных данных, строгих правил выполнения и предсказуемых результатов. Это хорошо работает для роботизированной автоматизации процессов (RPA), когда нужно заполнить форму или переместить файл, или для классических систем машинного обучения, где данные имеют фиксированную структуру. Однако бизнес-проблемы часто не укладываются в эти рамки. Мы имеем дело с неструктурированными текстами – электронными письмами, отзывами клиентов, чатами поддержки, юридическими документами. Здесь правила не всегда однозначны, а контекст играет решающую роль.
LLM, с их способностью понимать естественный язык, генерировать связный текст, обобщать информацию и даже делать выводы на основе контекста, предлагают совершенно новый класс решений. Но их возможности нельзя применять в лоб к общим, неспецифическим проблемам. Попытка поручить LLM «улучшить клиентский сервис» или «оптимизировать продажи» без предварительной декомпозиции обречена на провал. Это всё равно что пытаться использовать микроскоп для забивания гвоздей – инструмент мощный, но совершенно не по назначению. Недостаточно просто иметь LLM; нужно чётко понимать, какую конкретную часть проблемы она может решить, и как это решение вписывается в общий бизнес-процесс.
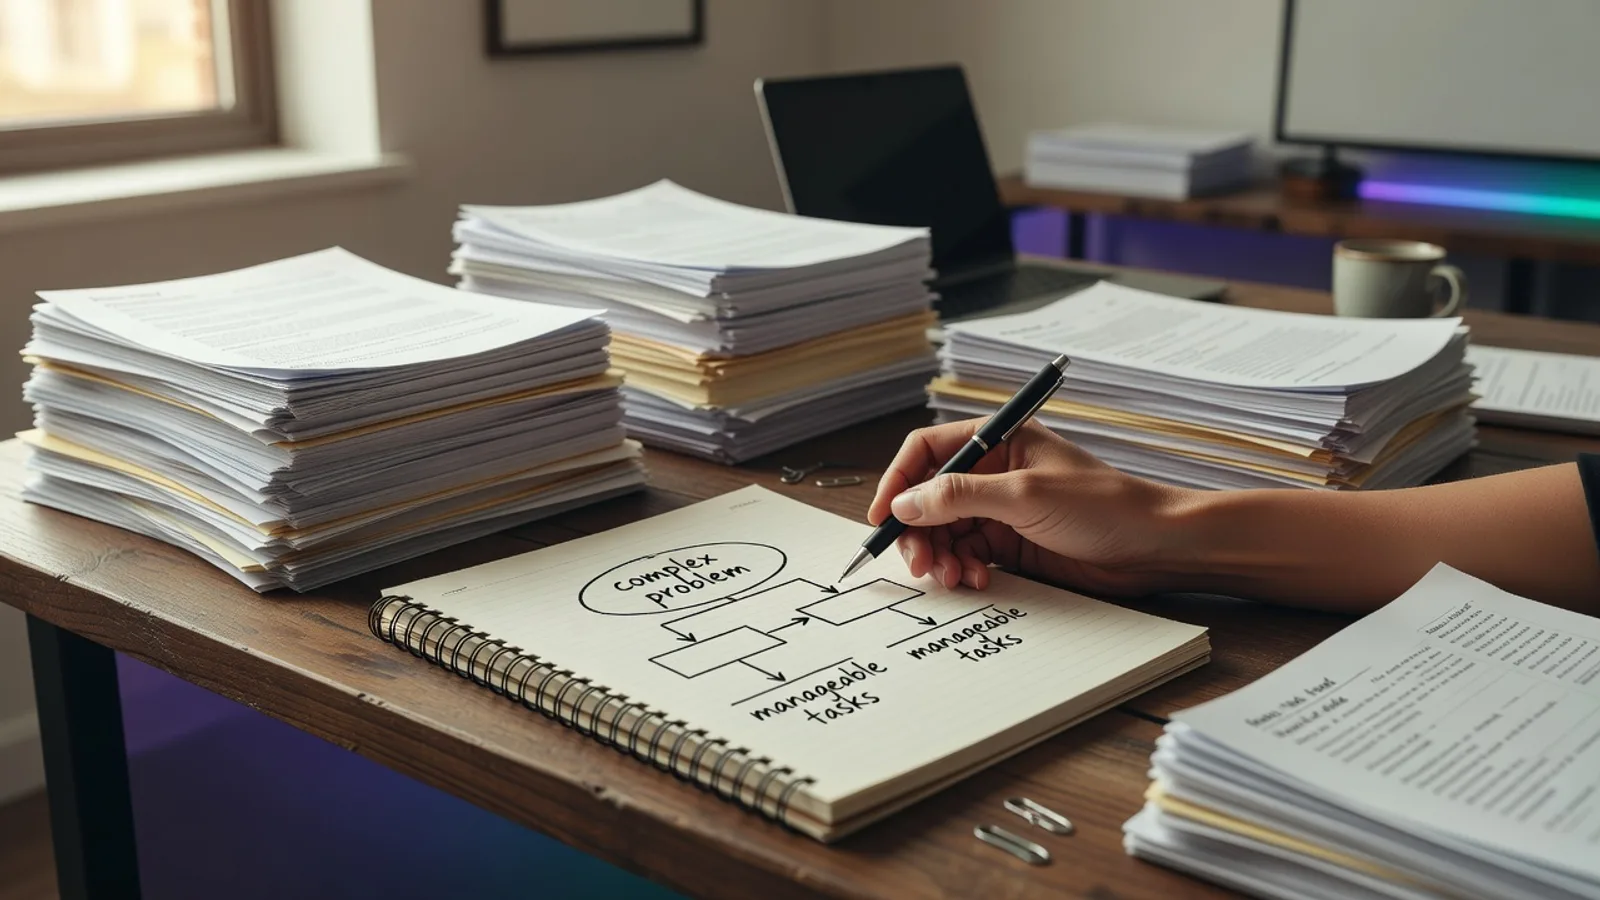
Декомпозиция – это процесс разбиения сложной системы или проблемы на более мелкие, простые и независимые части. Применительно к LLM-проектам, этот фреймворк включает несколько ключевых этапов, каждый из которых критически важен для успешного внедрения.
Начните с верхнего уровня: какова общая бизнес-проблема? Формулируйте её максимально чётко. Например, не «плохое обслуживание клиентов», а «высокое время ответа на клиентские запросы в пиковые часы, приводящее к снижению удовлетворённости». Затем определите измеримый желаемый результат: «сократить среднее время ответа на 30% и увеличить индекс удовлетворённости клиентов (CSAT) на 10 пунктов». Без чёткого понимания цели любые дальнейшие шаги будут бесполезны. Это основа для дальнейшего картирования и оценки успеха.
Визуализируйте весь процесс, который вы хотите улучшить. Используйте блок-схемы, BPMN-диаграммы или даже простые списки шагов. Отметьте все входные данные, действия, решения, точки взаимодействия с клиентами и системы, задействованные в процессе. Особое внимание уделите «бутылочным горлышкам» — местам, где процесс замедляется, требует много ручного труда, или где возникают ошибки. Именно эти участки являются потенциальными кандидатами для автоматизации с помощью LLM.
Теперь разбейте каждый шаг процесса на максимально мелкие, атомарные подзадачи. Например, «обработка клиентского запроса» может декомпозироваться на «классификация запроса», «извлечение ключевой информации», «поиск ответа в базе знаний», «формирование черновика ответа», «проверка черновика оператором», «отправка ответа». Чем мельче декомпозиция, тем легче будет соотнести каждую подзадачу с конкретной функцией LLM. Важно, чтобы каждая подзадача была чётко определена и имела свои входные и выходные данные.
Сложная проблема – это всего лишь набор простых проблем, которые мы ещё не научились разделять. Искусственный интеллект, особенно LLM, даёт нам новые инструменты для этой сепарации, но умение разделить – по-прежнему задача человека.
— Александра Петрова, руководитель направления ИИ-трансформации в крупном ритейлере
На этом этапе мы сопоставляем каждую атомарную подзадачу с одной или несколькими возможностями LLM. Это может быть:
Некоторые подзадачи могут не подходить для LLM, и это нормально. Для них останутся традиционные методы автоматизации или ручной труд. Цель – найти точки оптимального применения, а не автоматизировать всё любой ценой.
Для каждой подзадачи, которую можно автоматизировать с помощью LLM, оцените потенциальный эффект: сколько времени будет сэкономлено, как изменится качество, какие ресурсы будут высвобождены. Также важно оценить риски: точность LLM, потребность в дообучении, этические аспекты, стоимость внедрения и поддержки. Приоритизируйте задачи по потенциалу и управляемости рисков. Начните с тех, где эффект максимален, а риски минимальны – так называемые low-hanging fruit.
Рассмотрим реальный кейс, где фреймворк декомпозиции был успешно применён в крупной страховой компании для оптимизации обработки клиентских претензий. До внедрения LLM процесс выглядел так: клиент отправлял претензию по почте или через форму на сайте. Оператор вручную читал текст, определял тип претензии (например, задержка выплаты, ошибка в полисе, качество обслуживания), извлекал ключевые данные (номер полиса, дата инцидента, сумма), затем искал соответствующий шаблон ответа и адаптировал его. Среднее время обработки одной претензии составляло 45 минут, а количество ошибок при классификации достигало 15%.
Этот пример показывает, как сложная, многоступенчатая бизнес-проблема была успешно решена с помощью LLM, но только после её тщательной декомпозиции и точечного применения ИИ к конкретным подзадачам. Важно отметить, что человеческий контроль остался – LLM не полностью заменила оператора, но значительно повысила его эффективность.
Ошибки ии-проектов часто коренятся не в несовершенстве самой технологии, а в ошибочной постановке задачи. Мы ждём от LLM магии, когда нужно запрашивать конкретные, измеримые действия. Это как просить художника «нарисовать что-нибудь красивое» вместо «нарисовать портрет в стиле импрессионизма с конкретным освещением».
— Сергей Власов, директор по цифровой трансформации
Успешное внедрение ИИ в бизнес не означает полную замену человека. Напротив, это о создании гибридных систем, где LLM выполняют рутинные, повторяющиеся и объёмные задачи, а люди сосредоточены на анализе, принятии решений, творчестве и взаимодействии, требующем эмпатии. Очень важно предусмотреть механизмы человеческого контроля и обратной связи. LLM не идеальны, и их результаты могут требовать валидации, особенно на ранних этапах внедрения или в критически важных процессах.
Механизмы обратной связи должны быть встроены в процесс. Если LLM генерирует черновик ответа, оператор должен иметь возможность легко его скорректировать и отправить эту коррекцию обратно в систему для дообучения модели. Это непрерывный цикл улучшения. Без него LLM может со временем деградировать или стать нерелевантной меняющимся бизнес-условиям. Также важна масштабируемость: система должна быть способна обрабатывать возрастающие объёмы данных и запросов без значительного падения производительности или роста затрат.
Многие компании спешат внедрять большие языковые модели повсеместно, следуя тренду. Но такой подход редко приносит устойчивые результаты. Эффективность LLM проявляется там, где традиционные методы автоматизации сталкиваются с неразрешимыми проблемами: неструктурированные данные, необходимость понимания контекста, генерация уникального контента, сложность правил, которые невозможно формализовать в жёсткие алгоритмы. Я рекомендую рассматривать LLM как инструмент для масштабирования человеческого интеллекта, а не как замену всем существующим системам. Если задача поддаётся чёткой алгоритмизации с помощью скриптов и баз данных, LLM часто будут избыточны и менее эффективны.
Ключевое отличие LLM — это их способность работать с неопределённостью и неоднозначностью, интерпретировать человеческий язык, выявлять скрытые паттерны и генерировать связный, релевантный текст или код. Это особенно ценно в процессах, которые требуют высокой когнитивной нагрузки от сотрудников: анализ сложных документов, общение с клиентами в нестандартных ситуациях, творческое написание текстов, выявление инсайтов из большого объёма неструктурированной информации. Если ваш бизнес-процесс можно описать в виде строгой блок-схемы без множества "если-то" для непредсказуемых случаев, скорее всего, LLM тут принесёт мало пользы, а затраты на её интеграцию и поддержку окажутся неоправданными.
Каждый из этих сценариев характеризуется высокой степенью непредсказуемости входных данных или необходимостью гибкого, контекстно-зависимого ответа. Именно здесь LLM раскрывают свой потенциал, обеспечивая масштабирование процессов, которые ранее были ограничены возможностями и временем человеческих специалистов.
Даже самая мощная LLM — это лишь фундамент. Чтобы она приносила реальную пользу в бизнесе, требуется грамотная настройка. Здесь мы говорим о двух ключевых подходах: промпт-инжиниринге и тонкой настройке модели. Промпт-инжиниринг — это искусство составления запросов к модели таким образом, чтобы получить максимально релевантный и точный ответ. Это не просто формулировка вопроса, это целая методология, включающая в себя контекстуализацию, примеры, указания формата ответа и итеративную доработку.
Тонкая настройка (fine-tuning) же — это процесс адаптации предварительно обученной модели к конкретной задаче или домену с использованием собственного набора данных. Это позволяет модели не только лучше понимать специфику вашего бизнеса, но и генерировать ответы, соответствующие вашему корпоративному стилю, терминологии и правилам. Часто тонкая настройка даёт качественный скачок в производительности LLM по сравнению с использованием общедоступных моделей без неё, особенно в узкоспециализированных областях.
Промпт-инжиниринг является отправной точкой для большинства проектов с LLM. Это более быстрый и экономичный способ получить первые результаты. Он подходит, когда:
Эффективный промпт — это не просто инструкция, это диалог с моделью, который учит её видеть мир вашими глазами.
— Андрей Воронцов, ведущий AI-инженер
Тонкая настройка становится необходимой, когда стандартные промпты уже не справляются с требуемым уровнем точности, релевантности или стилистического соответствия. Это трудоёмкий процесс, который оправдан в следующих случаях:
На практике часто применяется гибридный подход: сначала модель тонко настраивается на специфичных для бизнеса данных, а затем уже к настроенной модели применяются техники промпт-инжиниринга для получения оптимальных результатов в конкретных задачах. Это позволяет добиться максимальной эффективности и управляемости.
Внедрение любой новой технологии в бизнес должно иметь измеримые результаты. LLM — не исключение. Однако из-за специфики их работы (генеративный характер, понимание контекста) традиционные метрики могут быть недостаточны. Важно сочетать количественные и качественные показатели, чтобы получить полную картину эффективности.
Чтобы метрики были полезны, их необходимо определить на этапе планирования проекта (Этап 1 и 5 фреймворка) и регулярно отслеживать. Только так можно понять, приносит ли LLM реальную ценность или является лишь дорогой игрушкой. Не забывайте о проведении A/B-тестирования для сравнения производительности LLM с текущими процессами или другими решениями.
Обсуждая внедрение LLM в бизнес-процессы, нельзя игнорировать этические вопросы. Мощность генеративных моделей несёт в себе как огромные возможности, так и потенциальные риски. Ответственное внедрение ИИ предполагает постоянное внимание к таким аспектам, как предвзятость данных, прозрачность решений, конфиденциальность информации и влияние на занятость. Простое делегирование задач ИИ без контроля может привести к непредсказуемым и даже вредоносным последствиям для компании и её клиентов.
Для ответственного внедрения LLM необходимо:
Помните, что ИИ — это мощный инструмент, но ответственность за его применение всегда лежит на человеке. Встраивание этических принципов в процесс разработки и внедрения LLM с самого начала обеспечит не только соответствие нормам, но и долгосрочное доверие со стороны клиентов и сотрудников.
Текущее применение LLM, хоть и впечатляюще, является лишь началом. Мы наблюдаем переход от простых ассистентов к более сложным автономным агентам, способным самостоятельно ставить цели, планировать действия, выполнять их и корректировать свой путь на основе обратной связи. Эта эволюция обещает ещё более глубокую трансформацию бизнес-процессов.
Автономные агенты — это следующий шаг в развитии LLM. Они не просто отвечают на вопросы или генерируют текст, они могут выполнять цепочки действий, взаимодействовать с внешними инструментами (базами данных, API, другими сервисами), принимать решения и даже учиться на своём опыте. Представьте себе агента, который самостоятельно исследует рынок, формирует отчёт, генерирует маркетинговую кампанию и запускает её, а затем анализирует результаты и предлагает корректировки. Это не фантастика, а активно развивающееся направление.
LLM открывают двери для беспрецедентного уровня персонализации. Мы говорим не просто о рекомендациях на основе предыдущих покупок, а о создании уникального опыта для каждого клиента:
Это требует глубокой интеграции LLM с различными системами данных, этического подхода к сбору и использованию информации, а также постоянного контроля со стороны человека. Потенциал огромен, но и требования к инфраструктуре и этическим стандартам возрастают многократно.
LLM позволяют автоматизировать задачи, которые ранее требовали человеческого интеллекта: понимание неструктурированных данных, генерацию текста, сложную коммуникацию, обеспечивая масштабирование и повышение эффективности в областях, где традиционные алгоритмы бессильны.
Оценивайте конкретные кейсы с измеримыми результатами, фокусируйтесь на решении чётко определённых бизнес-проблем, а не на общей идее "использовать ИИ". Всегда ищите доказательства эффективности и будьте критичны к общим заявлениям о прорывных возможностях.
Для тонкой настройки требуются качественные, размеченные данные, специфичные для вашей бизнес-области. Для промпт-инжиниринга нужны хорошие примеры запросов и желаемых ответов, чтобы "обучить" модель через контекст.
Для интеграции и поддержки LLM, особенно с тонкой настройкой, потребуется команда специалистов: инженеры по данным, инженеры по машинному обучению, промпт-инженеры. Но для начала можно использовать готовые API и небольшие эксперименты.
Измеряйте ROI через сокращение операционных расходов, увеличение производительности, улучшение качества клиентского сервиса (метрики CSAT/NPS), рост конверсии или снижение количества ошибок. Важно определить метрики до начала проекта.
"Галлюцинации" — это когда LLM генерирует фактически неверную, но правдоподобную информацию. Бороться с ними можно через тонкую настройку на релевантных данных, промпт-инжиниринг с указанием источников, а также внедрение "человека в контуре" для верификации критически важных ответов.
Основные риски включают предвзятость данных, проблемы с конфиденциальностью, "галлюцинации" модели, сложность объяснения решений ИИ и влияние на рабочие места. Все эти аспекты требуют постоянного внимания и внедрения этических руководств.
Это систематический подход к разбиению крупных, сложных бизнес-проблем на мелкие, управляемые компоненты, которые затем можно сопоставить с возможностями крупномасштабных языковых моделей (LLM) для автоматизации или оптимизации.
Традиционные методы часто фокусируются на жёстко структурированных данных и чётко определённых правилах. LLM же лучше справляются с неструктурированными данными, неоднозначностью и задачами, требующими понимания контекста, что делает необходимым другой подход к постановке задач.
Ключевые этапы включают определение цели, детальное описание текущего состояния, разбиение на подзадачи, идентификацию источников данных, картирование функционала LLM и оценку потенциального эффекта. Важен и пилотный запуск с последующей итерационной доработкой.
Типичные ошибки включают попытку автоматизировать весь процесс сразу, недооценку сложности интеграции, игнорирование необходимости человеческого надзора, а также некорректное тестирование и неспособность адаптировать модели к меняющимся бизнес-условиям.
В большинстве случаев LLM не заменяет человека полностью, а дополняет его, автоматизируя рутинные, объёмные или низкоуровневые задачи. Человек сохраняет роль эксперта, контролёра и принимает стратегические решения, основываясь на данных, обработанных LLM.
Экономическую эффективность оценивают через снижение операционных издержек, повышение производительности труда, сокращение времени выполнения задач, улучшение качества обслуживания клиентов и возможность масштабирования бизнеса без пропорционального роста затрат. Важно учитывать и непрямые выгоды.
Картирование функционала LLM – это процесс сопоставления декомпозированных подзадач с конкретными возможностями крупномасштабных языковых моделей. Например, подзадача «обобщение отзывов» картируется на функционал LLM по суммаризации текста, а «классификация запросов» – на классификацию с использованием заданного набора категорий.
Для эффективного обучения и тонкой настройки LLM требуются большие объёмы качественных, релевантных и, по возможности, размеченных данных. Это могут быть текстовые документы, диалоги, отчёты, клиентские запросы — всё, что отражает специфику бизнес-процесса, который планируется автоматизировать.


Комментарии (0)
Без регистрации. Комментарии проверяются автоматически перед публикацией.
Пока нет комментариев. Будьте первым!