Для стартапа, монетизирующего уникальные поведенческие данные, Product-Market Fit (PMF) означает, что продукт решает значимую проблему для целевой аудитории с помощью этих данных, и пользователи активно его используют, а юнит-экономика подтверждает масштабируемость за счёт положительных показателей LTV/CAC и Retention.

Для стартапа, который монетизирует уникальные поведенческие данные, Product-Market Fit (PMF) означает, что продукт, основанный на этих данных, находит глубокий отклик у целевой аудитории, решая её значимые проблемы. Это проявляется в активном и устойчивом использовании продукта, а также в способности генерировать прибыль. Юнит-экономика, в свою очередь, должна подтвердить масштабируемость этой бизнес-модели, демонстрируя положительное соотношение LTV к CAC и высокий уровень удержания пользователей. Суть — способность превращать данные в измеримую ценность, за которую потребитель готов платить, при этом издержки на привлечение и обслуживание этого потребителя остаются в контролируемых рамках.
Product-Market Fit (PMF) — это состояние, когда стартап успешно удовлетворяет потребность целевого рынка своим продуктом. Для стартапов, монетизирующих поведенческие данные, концепция PMF приобретает дополнительные измерения. Здесь недостаточно просто иметь продукт, который нравится пользователям. Необходимо, чтобы ценность продукта прямо зависела от собираемых и обрабатываемых данных, а сами данные были достаточно уникальными или комплексными для создания устойчивого конкурентного преимущества.
Ключевая задача — понять, как пользователи воспринимают ценность, генерируемую данными. Это может быть персонализированный сервис, улучшенная рекомендательная система, более точный прогноз или глубокая аналитика. Важно, чтобы эта ценность не могла быть легко воспроизведена конкурентами без доступа к аналогичному массиву поведенческих данных.
Измерение PMF для дата-центричного стартапа требует специфических метрик помимо стандартных. Опрос Шона Эллиса (Sean Ellis Test), где более 40% пользователей говорят, что «очень расстроятся», если продукт исчезнет, остаётся актуальным, но его необходимо дополнить анализом поведенческих показателей.
Product-Market Fit для нас означает, что данные, которые мы собираем, не просто лежат мертвым грузом, а активно используются для решения критических проблем наших клиентов, и они видят в этом не просто удобство, а реальное конкурентное преимущество. Если нет этой связи, нет и PMF.
— Наталья Ганина, сооснователь DataCore Analytics
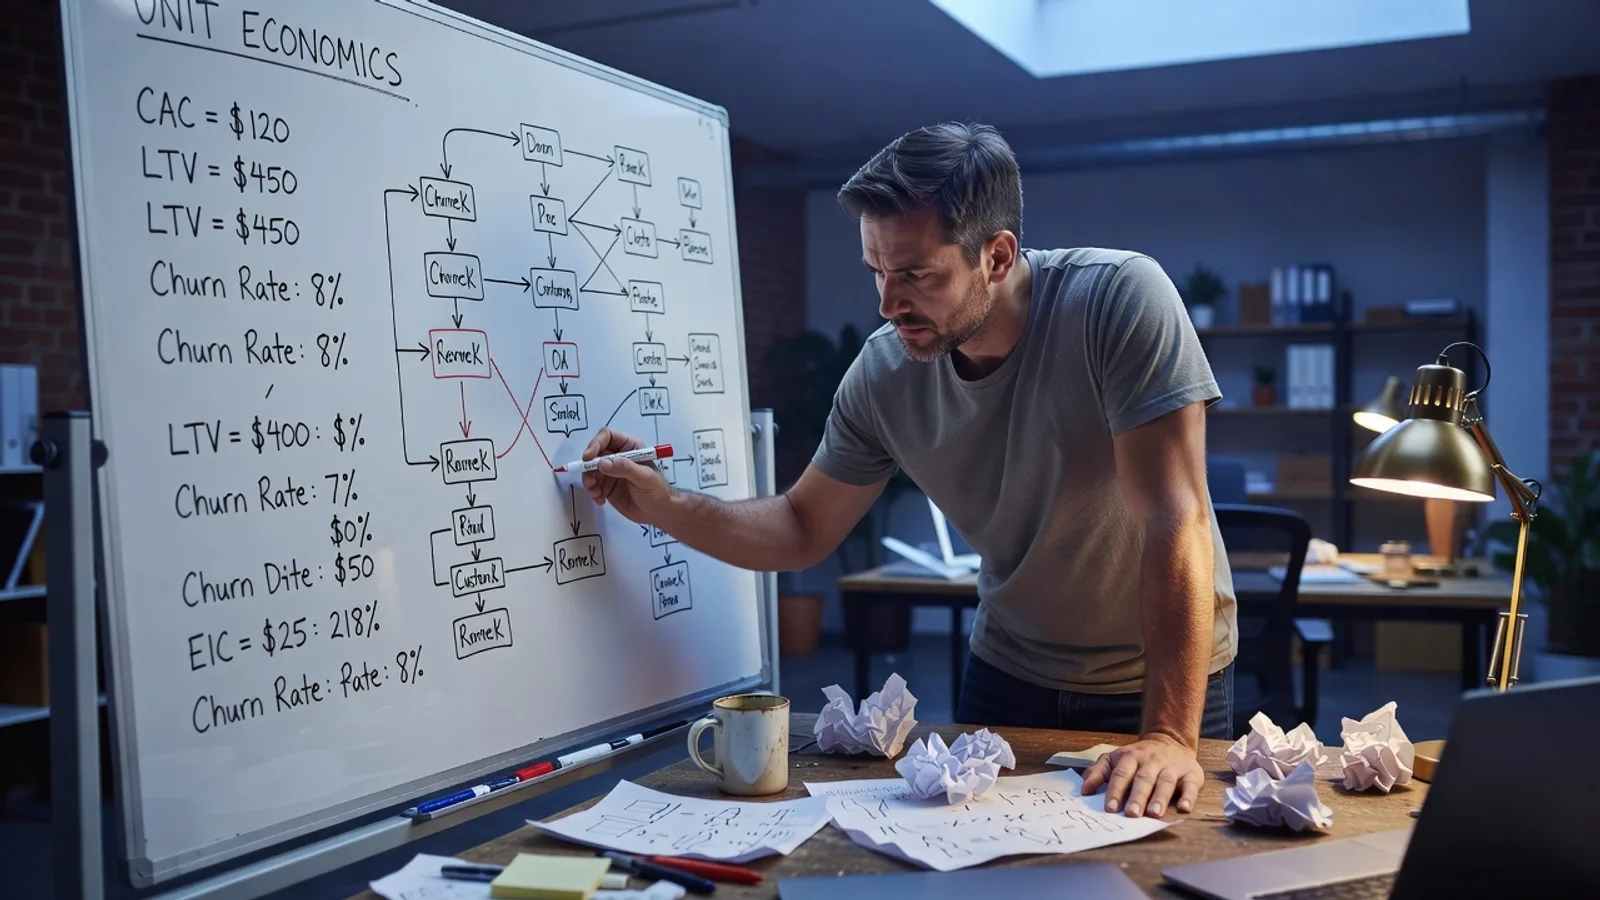
После подтверждения Product-Market Fit, критически важно построить устойчивую юнит-экономику. Это позволяет понять, может ли стартап расти прибыльно. Основные компоненты юнит-экономики — Customer Acquisition Cost (CAC) и Lifetime Value (LTV) — должны быть рассчитаны с учётом специфики монетизации поведенческих данных.
CAC – это общая сумма расходов на привлечение одного платящего клиента. Для стартапов, работающих с данными, CAC может быть как выше, так и ниже среднего, в зависимости от модели привлечения и уровня доверия к продукту, который работает с конфиденциальной информацией.
Пример: Если стартап потратил 100 000 рублей на маркетинг и продажи, и привлёк 20 новых клиентов за месяц, то CAC составляет 5 000 рублей. В случае с уникальными данными, CAC может значительно варьироваться. Для B2B SaaS средний CAC может составлять от 500 до 5000 долларов, а для B2C — от 10 до 100 долларов.
LTV — это общая сумма дохода, которую стартап ожидает получить от клиента за весь период его взаимодействия с продуктом. Для продуктов, монетизирующих данные, LTV может быть чрезвычайно высоким, так как ценность продукта часто растёт с течением времени и накоплением данных.
Формула LTV: (ARPU * Gross Margin) / Churn Rate. Например, если ARPU составляет 5 000 рублей, валовая маржа 80%, а Churn Rate 2% в месяц, то LTV = (5000 * 0.8) / 0.02 = 200 000 рублей. Это значительно выше CAC, что указывает на здоровую юнит-экономику.
Рассмотрим гипотетический стартап «SkillUp», который предлагает платформу для онлайн-обучения, используя уникальные поведенческие данные о стиле обучения, скорости усвоения материала и предпочтениях студентов. Эти данные используются для динамической адаптации учебного контента и персональных рекомендаций.
Эти метрики говорят о наличии устойчивого Product-Market Fit, обусловленного именно уникальной ценностью, которую создают поведенческие данные.
SkillUp использует подписочную модель. Средняя стоимость подписки — 1500 рублей в месяц.
Теперь рассчитаем LTV:
LTV = (ARPU * Gross Margin) / Churn Rate = (1500 рублей * 0.7) / 0.03 = 1050 / 0.03 = 35 000 рублей.
Соотношение LTV к CAC = 35 000 / 4500 = 7.7:1. Это превосходный показатель, который указывает на здоровую и масштабируемую юнит-экономику. Высокий LTV напрямую связан с тем, что уникальные поведенческие данные позволяют SkillUp удерживать студентов значительно дольше и предоставлять им более ценный продукт.
Монетизация поведенческих данных — это не только прямые подписки или продажи. Существует несколько моделей, каждая из которых имеет свои особенности в расчёте юнит-экономики.
Каждая модель требует тщательного анализа влияния на CAC и LTV. Например, рекламная модель может иметь низкий CAC (так как продукт часто бесплатен), но LTV будет зависеть от эффективности рекламных кампаний и способности удерживать большую аудиторию.
Монетизация поведенческих данных сопряжена с рядом рисков, которые напрямую влияют на юнит-экономику и PMF:
Стратегия работы с данными должна учитывать эти риски с самого начала. Инвестиции в безопасность, прозрачность политики конфиденциальности и обучение пользователей могут показаться дополнительными затратами, но они критически важны для долгосрочной устойчивости юнит-экономики.
Достижение Product-Market Fit и положительной юнит-экономики — это лишь фундамент. Для стартапа, монетизирующего поведенческие данные, следующим этапом становится стратегическое масштабирование. Здесь важны не только рост числа пользователей, но и увеличение ценности данных, углубление их анализа и расширение применимости. Это требует системного подхода к развитию продукта, маркетингу и операционной деятельности.
Масштабирование продукта, основанного на данных, не означает простое добавление новых функций. Это непрерывный процесс оптимизации текущих алгоритмов, персонализационных моделей и пользовательского опыта. Ключевую роль играет A/B-тестирование, позволяющее проверять гипотезы о влиянии изменений на ключевые метрики вовлечённости и монетизации.
Например, платформа, агрегирующая данные о поведении пользователя в сфере недвижимости, может тестировать различные алгоритмы подбора объектов. Изменение в алгоритме, повышающее конверсию просмотра объявления в запрос на показ на 3%, при десятках тысяч ежедневных просмотров, может принести миллионы дополнительной выручки в месяц. Важно, чтобы метрики для A/B-тестов были чётко привязаны к LTV и retention, а не только к сиюминутным показателям.
Ещё один аспект — тестирование ценовых моделей. Для SaaS-решений, работающих с данными, изменение тарифных планов или добавление премиум-функций, основанных на углублённой аналитике, требует осторожности. Мелкие корректировки цен, протестированные на небольшой выборке пользователей, могут увеличить ARPU на 5-10% без существенного падения конверсии. Но без данных о PMF и юнит-экономике такие эксперименты рискованны.
После подтверждения PMF и положительной юнит-экономики, основная задача — эффективное масштабирование CAC. Это означает поиск новых, более дешёвых или более конверсионных каналов привлечения. Если на старте команда фокусировалась на платной рекламе в узких сегментах, то на этапе масштабирования стоит исследовать партнёрства, реферальные программы, SEO/контент-маркетинг, а также виральный маркетинг, если продукт располагает к нему.
Для стартапов, монетизирующих поведенческие данные, органический рост за счёт виральности или сарафанного радио часто недооценивается. Продукт, который действительно решает проблему пользователя, стимулирует его рекомендовать сервис. Однако это не пассивный процесс. Необходимо создавать стимулы для рекомендаций, например, предлагать бонусы за приведённых друзей. При адекватном LTV, компания может позволить себе тратить на эти бонусы до 10-15% от среднего LTV нового пользователя, оставаясь в плюсе.
«Масштабирование — это не только про поиск новых клиентов, но и про повышение ценности для существующих. Удержание клиента, LTV которого превышает CAC в 3 и более раза, обходится компании в 5-10 раз дешевле, чем привлечение нового».
— Энди Данлоп, венчурный инвестор
Работа с retention также становится более тонкой. Используются персонализированные триггерные рассылки, ретаргетинг, эксклюзивный контент для лояльных пользователей. Цель — не просто удержать, а увеличить частоту использования и потребления ценности, что напрямую влияет на LTV. Например, для B2B SaaS, предлагающего аналитику на основе данных, повышение ежемесячной активности пользователей на 10% за счёт улучшения UX и добавления новых отчётов, может увеличить годовой LTV на 15-20% без дополнительных затрат на привлечение.
Стартапы, монетизирующие поведенческие данные, всегда сталкиваются с повышенным вниманием к этическим и регуляторным вопросам. Недостаточно просто собрать данные и использовать их для улучшения продукта. Важно выстроить прозрачную политику приватности и получить явное согласие пользователя на обработку его информации. Это не только требование законодательства (например, GDPR, ФЗ-152 в России), но и критически важный фактор доверия, влияющий на retention и виральность.
В 2026 году требования к защите данных только ужесточаются. Продукты, которые не предоставляют пользователям чёткий контроль над их данными, или непрозрачно их используют, рискуют столкнуться не только с штрафами, но и с массовым оттоком. Примеры крупных технологических компаний, теряющих миллиарды из-за скандалов с утечками или некорректным использованием данных, показывают, что риски здесь высоки. Это прямо влияет на LTV, поскольку подрывает базовое доверие.
Обеспечение прозрачности — это не просто размещение длинного юридического документа. Это интеграция механизмов контроля в сам продукт. Например, панель управления, где пользователь может видеть, какие данные о нём собираются, как они используются, и может легко отозвать своё согласие или удалить часть информации. Некоторые компании идут дальше, предлагая пользователям монетизировать свои данные самостоятельно, если они согласны их предоставить. Это создаёт новую модель отношений и может повысить LTV, превращая пользователя из пассивного источника данных в активного партнёра.
Представьте стартап в области здоровья, который собирает данные о физической активности. Если он предоставляет пользователю детальный отчёт о том, как его данные анонимно агрегируются для научных исследований и какую ценность это приносит, пользователи с большей охотой будут делиться информацией. Такой подход может стать дифференциатором, увеличивающим лояльность и снижающим CAC за счёт позитивного пиара и сарафанного радио.
В ближайшие годы концепция Product-Market Fit для стартапов, оперирующих уникальными поведенческими данными, будет эволюционировать. Основной акцент сместится от простого соответствия продукта рынку к созданию устойчивой экосистемы, где данные выступают центральной ценностью. Это означает более глубокую интеграцию данных в каждый аспект продукта и бизнес-модели, а также постоянное переосмысление того, какую именно проблему решают эти данные.
Например, стартап, который сейчас монетизирует данные о предпочтениях в одежде для персонализированных рекомендаций, может начать предлагать производителям одежды инсайты о трендах, а дизайнерам — метрики реакции на новые коллекции. Это расширение модели монетизации, основанной на тех же данных, но с новыми ценностными предложениями для разных сегментов рынка. Такой подход требует постоянного поиска новых «фитов» в рамках уже собранного дата-сета.
Искусственный интеллект и машинное обучение станут ещё более центральными для достижения и поддержания PMF. Эти технологии позволяют не только агрегировать и анализировать данные, но и предсказывать поведение пользователей, персонализировать предложения в реальном времени и автоматизировать оптимизацию. Например, предиктивная аналитика может помочь идентифицировать пользователей с высоким риском оттока и автоматически запускать для них кампании по удержанию, тем самым непосредственно влияя на retention и LTV.
Для стартапов, работающих с поведенческими данными, это означает необходимость постоянных инвестиций в R&D в области AI. Разработка более точных моделей предсказания, создание новых алгоритмов сегментации и персонализации — это не просто улучшение продукта, это инвестиции в будущий PMF и устойчивость юнит-экономики. Компании, которые смогут лучше всех предсказывать потребности своих пользователей, используя их поведенческие данные, будут лидерами рынка.
«В мире данных PMF — это не статичное состояние, а непрерывный процесс адаптации. Ваш продукт должен постоянно находить новые способы решать проблемы пользователей, которые ещё не сформулированы, используя данные, которые вы уже собрали».
— Артем Ковалёв
В конечном итоге, успех стартапа, монетизирующего уникальные поведенческие данные, будет определяться его способностью не только найти PMF, но и постоянно его переосмысливать и расширять, сохраняя при этом положительную юнит-экономику и высокий уровень доверия пользователей. Это сложная, но крайне перспективная задача, требующая стратегического видения и глубокого понимания метрик.
Уникальные поведенческие данные — это информация о действиях пользователей, которую стартап собирает или агрегирует таким образом, что она представляет новую, трудновоспроизводимую ценность. Например, данные о неявных предпочтениях пользователя, его когнитивных паттернах или сложных взаимодействиях с контентом, которые не очевидны из прямых запросов. Эта уникальность позволяет создать дифференцированный продукт и получить конкурентное преимущество.
Для дата-стартапов PMF не ограничивается лишь соответствием продукта потребностям пользователя. Он также включает «data-product fit» — насколько эффективно собранные данные позволяют создавать уникальную ценность. Это означает, что продукт не только решает проблему, но и делает это лучше, чем конкуренты, именно за счёт своих данных.
Для дата-стартапов, помимо CAC и LTV, критически важны метрики, связанные с качеством и ценностью данных: Data Acquisition Cost (стоимость сбора данных), Data Usage Rate (частота использования данных в продукте), Data Freshness (актуальность данных), а также метрики, отражающие точность алгоритмов, основанных на этих данных (например, точность рекомендаций или предсказаний).
Этика имеет прямое влияние на юнит-экономику. Нарушение приватности или непрозрачное использование данных может привести к массовому оттоку пользователей, снижению LTV и увеличению CAC из-за необходимости восстанавливать репутацию. Доверие — это валюта в экономике данных, и его потеря обходится очень дорого.
Теоретически, можно найти группу пользователей, которым продукт действительно нужен (PMF), но если стоимость их привлечения (CAC) выше, чем их ценность за время жизни (LTV), то юнит-экономика будет отрицательной. В таком случае, PMF существует, но масштабироваться компания не сможет. Необходимо либо снижать CAC, либо увеличивать LTV, либо и то, и другое.
PMF — это не статичный показатель, а динамическое состояние. Для масштабируемого стартапа следует проводить регулярные проверки PMF (например, ежеквартально), особенно после значительных изменений в продукте, целевой аудитории или рыночной среде. Юнит-экономику необходимо отслеживать непрерывно, корректируя модели и стратегии по мере накопления данных.
Основные риски при масштабировании дата-стартапа с положительной юнит-экономикой включают ухудшение качества данных при быстром росте, столкновение с новыми регуляторными барьерами, появление сильных конкурентов, предлагающих аналогичные решения на основе данных, а также потерю уникальности данных или неспособность постоянно извлекать из них новую ценность.
Product-Market Fit в данном контексте означает, что ваш продукт, использующий поведенческие данные, находит значимый отклик у целевой аудитории, решая их реальные проблемы. Пользователи активно возвращаются к продукту, а органический рост превышает затраты на привлечение.
Ключевые метрики включают процент удержания (Retention Rate), показатель виральности (K-factor), частоту использования продукта, NPS (Net Promoter Score) и, что критично, рост количества и качества используемых данных, которые напрямую влияют на ценность продукта.
Поведенческие данные могут существенно снизить CAC (Customer Acquisition Cost) за счёт более точного таргетинга и персонализации, а также повысить LTV (Lifetime Value) через улучшение продукта, предсказание оттока и кросс-продажи, формируя более прочную юнит-экономику.
Для большинства стартапов на ранней стадии желаемое соотношение LTV к CAC должно быть не менее 3:1. Однако для стартапов, монетизирующих уникальные данные, это соотношение может быть выше за счет масштабирования ценности данных, достигая 5:1 и более при эффективном использовании.
Retention Rate прямо указывает, насколько хорошо продукт удерживает пользователей и продолжает приносить им ценность. Высокий Retention является одним из наиболее надёжных признаков наличия Product-Market Fit, особенно когда ценность продукта растёт с увеличением объёма данных.
Избегайте усреднения всех пользователей при расчёте LTV; сегментируйте их по когортам и паттернам поведения. Не игнорируйте затраты на хранение и обработку данных, а также на соблюдение регуляторных требований (например, GDPR/ФЗ-152). Важно учитывать, что CAC может меняться в зависимости от каналов привлечения и качества данных.


Комментарии (0)
Без регистрации. Комментарии проверяются автоматически перед публикацией.
Пока нет комментариев. Будьте первым!